
小資源能跑 Agent,但撐得起一個部門嗎?
本地模型長文件任務實測:調校、背景作業與並發承載
摘要
前篇〈本地模型能撐起 AI Agent 工作流嗎?〉的結論是:在單台 DGX Spark 這個級距,本地模型還撐不起正式的 agent 服務。這一次,我們換了一個更接近日常工作的任務——讓 agent 讀報價單、算 TCO、套用公司範本產出文件,再經過兩輪修訂——並把重點從「一個人能不能用」推進到「一個部門能不能用」。
| 問題 | 實測結果 |
|---|---|
| 16 GB 消費級顯示卡做得到嗎? | 做得完,但撞牆的不是主任務,而是 agent 自己的背景作業 |
| DGX Spark 調校後能快多少? | 換對推論引擎與模型後,同一個任務從約 134 分鐘降到 25~37 分鐘(兩輪) |
| 這樣就能用了嗎? | 單人每則訊息仍要等 3.5~11 分鐘(未含上網查詢);產出的文件仍有計算與推論錯誤,需要人工複查 |
| 一台 Spark 能同時服務幾個人? | 3 個同時進行的任務;到第 4 個時 KV 快取用滿,部分訊息的等待時間暴增到 3.2 倍 |
結論很直接:小資源可以把 agent 調到「能完成」,但從「能完成」到「一個部門每天在用」,中間差的是記憶體頻寬、KV 快取容量與並發能力。文末我們依實驗數據,推估了 DGX B300、DGX Station 與 RTX PRO 6000 伺服器的承載能力;搭配 Run:ai 動態調度,同一台 DGX B300 在上班時段可同時服務的任務數,推估還能比固定切分多出約 75%。
為什麼做這個測試
前篇的後記留下兩個待驗證的方向:降低權重精度,以及讓 prefix caching(前綴快取)生效,都可能讓 Spark 變快。這次我們把這兩點都實際做了。
另一個原因是任務本身。前篇用的是六題 Jira 查詢與匯出,每題相對獨立;但企業裡更常見的是長文件、多輪修訂的工作:同一份文件改了又改,對話越拉越長,agent 要記住前面的計算與決定。這類任務對 context 長度與記憶體的壓力完全不同。
最後,也是最實際的問題:就算一個人用得順,部門裡五個、十個人同時用時會怎樣?這是採購規劃時真正需要的數字。
測試環境與方法
| 項目 | RTX 5070 Ti 平台 | DGX Spark |
|---|---|---|
| GPU/記憶體 | RTX 5070 Ti 16 GB(虛擬機直通) | GB10,128 GB 統一記憶體,頻寬 273 GB/s |
| 推論引擎與模型 | llama.cpp+Qwen3.8-27B(4-bit 量化),context 64K | 三種方案,見第五節;context 262K |
| Agent | Hermes Agent(開源,以下簡稱 hermes),以 Discord 為操作介面,經 LiteLLM 閘道連線到模型 | |
任務內容:四則固定訊息,附件為 GPU 報價單(Excel)與公司專案文件範本(Word)。
- 依指定參數計算「租用算力 vs 自建 DGX B300」的 3 年與 5 年 TCO,包含租用時有無 NVIDIA AI Enterprise 訂閱的兩種情境
- 使用上傳的範本,產出 v1.0 文件
- 核對報價單上 3/4/5 年的軟體訂閱價,確認 5 年方案是否正確引用,並更新文件
- 在結論前新增電價與租用價格各 ±20% 的敏感性分析,並更新文件
為了減少干擾、讓各輪的條件一致,訊息 1 明確要求 agent 不要上網查詢、不要提出澄清問題,所需的參數都直接寫在訊息中。但在實際工作中,上網查找資料(例如最新的租用行情或產品規格)是很正常的一環,也會增加不少工作時間。本文的耗時數字都不含這類延伸工作。
量測方式:每則訊息的耗時,以 hermes 紀錄中「收到訊息 → 回覆完成」計算;context 大小一律採用模型呼叫的實際 token 數,不採用 agent 的粗估值。
測試條件說明
一、同一種設定只跑了一至兩輪,而 agent 每一輪走的路徑差異很大,單輪數字只代表一次結果。
二、5070 Ti 與 Spark 的測試採用不同的送訊規則,兩個平台的耗時不直接比較。
三、並發測試以「重播實際請求」的方式進行,沒有用真實的多人 session 驗證。
四、本次沒有雲端模型的對照輪次。
五、任務排除了上網查詢等延伸工作;實際使用時,每則訊息的耗時會更長。
六、文件中的金額與報價資訊一律不揭露。
16 GB 顯示卡:撞牆的是 agent 自己
在 5070 Ti 上,27B 模型只能開到 64K 的 context。任務本身做得完,但多輪測試中出現了多次輸出被截斷,以及 KV 快取空間耗盡的錯誤。追查紀錄後發現:主任務本身從來沒有因為 context 不足而截斷,問題全部出在 agent 的「背景檢討」。
什麼是背景檢討
hermes 在一輪對話結束後,會視條件啟動一個背景作業,回頭檢討這一輪,決定要不要修改 skill。預設情況下,它會重播完整對話,而且本身不會壓縮。結果是:
- 背景檢討一開始就帶著接近 6 萬 tokens 的對話,很容易撞到 64K 的上限,接續生成時又再撞一次,連續截斷
- 它和使用者送出的下一則訊息常常同時執行。這台的推論服務是兩個請求共用 64K 的 KV 空間,背景檢討已佔用近 6 萬 tokens 時,下一則訊息觸發的壓縮請求一進來,空間就不夠了,兩個請求同時被中止
把壓縮門檻調低到 48,000 tokens 後,兩輪測試都沒有再發生截斷,但代價是壓縮次數變多(3~5 次),每輪光是壓縮就花了約 20 分鐘。
容量不只要放得下模型權重,也要留給 agent 自己的背景作業。單一使用者就會讓推論服務同時處理多個請求,這一點在後面的並發測試中會再看到。
補充說明:前篇後記-2 提到,hermes 在同一則指令的連續工具呼叫之間不會壓縮對話。我們進一步查閱原始碼後發現,hermes 在工具迴圈中其實也會檢查並壓縮;當時沒有觸發,是因為最大的單一請求(51,296 tokens)仍低於 64K 模型的壓縮門檻(64,000 tokens)。
DGX Spark:換對引擎與模型,快了三到五倍
先看天花板:頻寬
Spark 的記憶體很大(128 GB),但頻寬只有 273 GB/s。一般的密集模型每產生一個 token,都要把整份權重讀過一次,生成速度的上限大約就是「頻寬 ÷ 權重大小」。實測 27B 的 8-bit 版本每秒 8.71 個 token,已經達到這個上限的 92%,只調參數幾乎沒有空間。
所以方向只剩兩個:讓每個 token 要讀的資料變少(降低精度、改用 MoE 模型),或一次產生多個 token(推測解碼)。前篇留下的「降低權重精度」,這次的實測是:同一個 27B 改用 4-bit 量化,每秒從 8.71 提高到 15.18 個 token;前篇使用未量化的版本時,只有每秒約 4.1~4.5 個。
三種推論方案的任務實測
| 輪次 | 推論引擎與模型 | 四則訊息合計 |
|---|---|---|
| S1 | llama.cpp+Qwen3.8-27B(4-bit 量化) | 133.8 分鐘 |
| S2 | SGLang+Qwen3.8-27B(NVFP4)+推測解碼 | 64.0 分鐘 |
| S3 | vLLM+Qwen3.8-Flash-Next(MoE,NVFP4)+MTP | 37.0 分鐘 |
| S4 | 同 S3(第二輪) | 24.7 分鐘 |
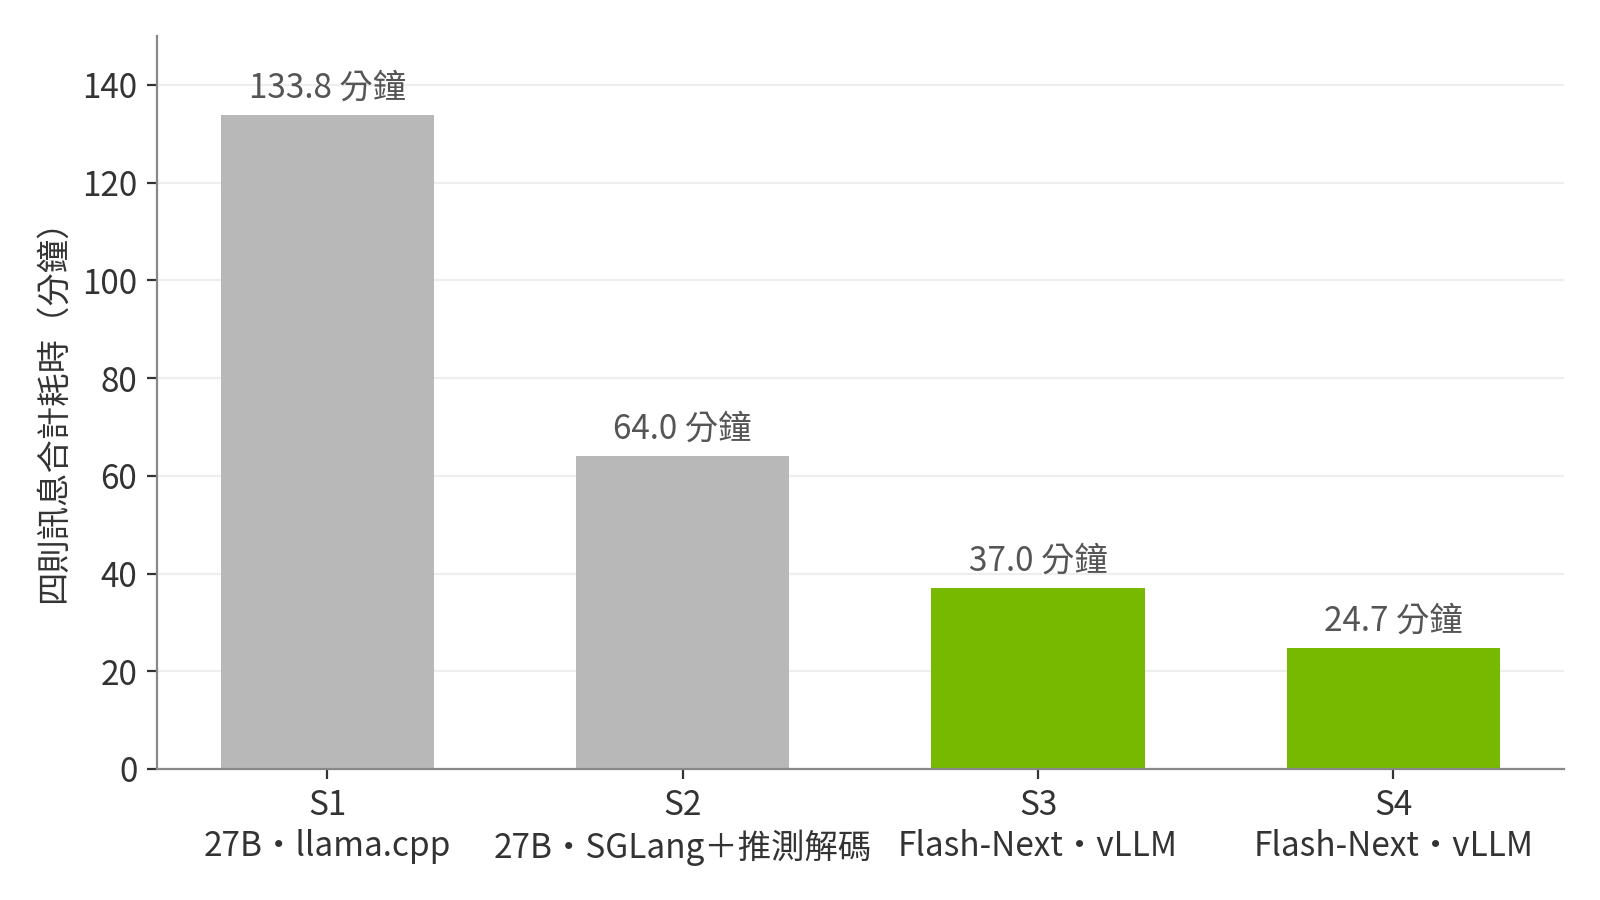
Spark 上四輪任務測試的四則訊息合計耗時
四輪都沒有截斷或錯誤。262K 的 context 讓背景檢討即使帶著約 13 萬 tokens 的對話也能正常完成,這是 64K 的 5070 Ti 做不到的。
最後採用的 Qwen3.8-Flash-Next 是 MoE 模型,總參數約 176B,但每個 token 只啟用約 6B,正好適合「記憶體大、頻寬低」的 Spark。前篇的另一個方向「讓 prefix caching 生效」,在這個方案上也確認有效:同一段提示第二次送入時,處理時間從 5.25 秒降到 0.93 秒。
不過,有幾個代價要一併說明:
- 推測解碼的效果很依賴內容:以 SGLang 的推測解碼為例,生成程式碼時每秒約 25~37 個 token,中文長文則只有約 15~22 個。評估時要用接近實際工作的內容量測,不能只看廠商或社群公布的數字
- 整台機器只能跑這一個模型:Flash-Next 會使用約 80% 的統一記憶體,無法同時執行 Run:ai 等其他工作負載
- 依賴社群修改的部署方案:日後的更新與維護,要跟著社群專案的進度
- 同一設定,每輪差異也很大:S3 與 S4 的設定完全相同,耗時卻相差約 12 分鐘。對外引用單人的數字時,我們以範圍(約 25~37 分鐘)呈現
產出品質:數字大多正確,但仍需人工複查
我們逐項驗算了每一輪最終版文件的計算結果。核心的 TCO 數字大多正確,錯誤集中在幾個地方:
- 表格中的計算:有一輪在差額表中把一個負值寫成正值,與同一份文件的摘要和結論互相矛盾
- 敏感性分析的推論:多輪出現結論與表中數字不符的情況,例如宣稱某個情境下結果會翻轉,但實際數字並沒有翻轉
- 說明文字:百分比的分母混用、用詞不精確,偶爾也會混入簡體字
- 對話中的摘要與文件不一致:agent 在聊天回覆中的重點整理,有時含有文件裡沒有的錯誤數字
文件格式方面,表格欄寬錯亂、資料列多出底色等問題,我們已追查到原因出在 skill 附帶的程式;測試完成後改良 skill,這些問題就能獲得改善。只是為了讓各輪的條件一致,測試時每次倒回的快照都沒有修改 skill,所以這些格式問題在各輪中仍可能出現。至於計算與推論的錯誤,目前只能靠人工複查把關。換句話說,這個任務的產出可以作為初稿,但還不能直接交給客戶。
從一個人到一個部門:一台 Spark 能同時服務幾人?
為什麼需要測並發
前面提過,單一使用者就會讓推論服務同時處理多個請求:主任務、背景檢討、壓縮摘要可能同時在跑。部門裡多人同時使用時,這些請求會疊加。單人的耗時無法回答「能同時服務幾個人」,必須實測。
測試方法:重播實際請求
我們讓 LLM 閘道完整保存 S4 這一輪的 75 次模型呼叫(主任務 45 次、背景檢討 22 次、其他輔助呼叫 8 次),再依照原本的先後順序與時間間隔,同時重播 N 份到 Spark:
- 工具執行、使用者送訊等間隔沿用原始秒數;系統變慢時,後續請求也會跟著延後,與真實情況相同
- 每個請求強制產生和原本相同長度的輸出
- 每一份重播加上不同的識別標記,避免不同份之間共用快取而讓結果過於樂觀
- 各份錯開 60 秒起跑,模擬不同使用者陸續開始工作
先驗證方法本身:只重播 1 份時,四則訊息合計為 1,452.6 秒,與 S4 實際的 1,478.7 秒只差 1.8%。
判定標準:每則訊息的耗時不超過單人時的 2 倍,且沒有錯誤;以 N 份中最差的一份判定。
結果
| 同時進行的任務數 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| 四則合計(相對單人) | 基準 | +29%~+31% | +49%~+60% | +115%~+123% |
| 最差的一則訊息(相對單人) | — | 1.42 倍 | 1.86 倍 | 3.24 倍 |
| 判定 | — | 通過 | 通過 | 未通過 |
| 最多同時執行的請求數 | 2 | 4 | 6 | 8 |
| 是否出現排隊 | 否 | 否 | 否 | 是 |
| 首字延遲最長 | 3.9 秒 | 4.0 秒 | 7.2 秒 | 64.8 秒 |
| KV 快取最高使用率 | 20.9% | 38.0% | 53.7% | 99.2% |
| 錯誤 | 0 | 0 | 0 | 0 |
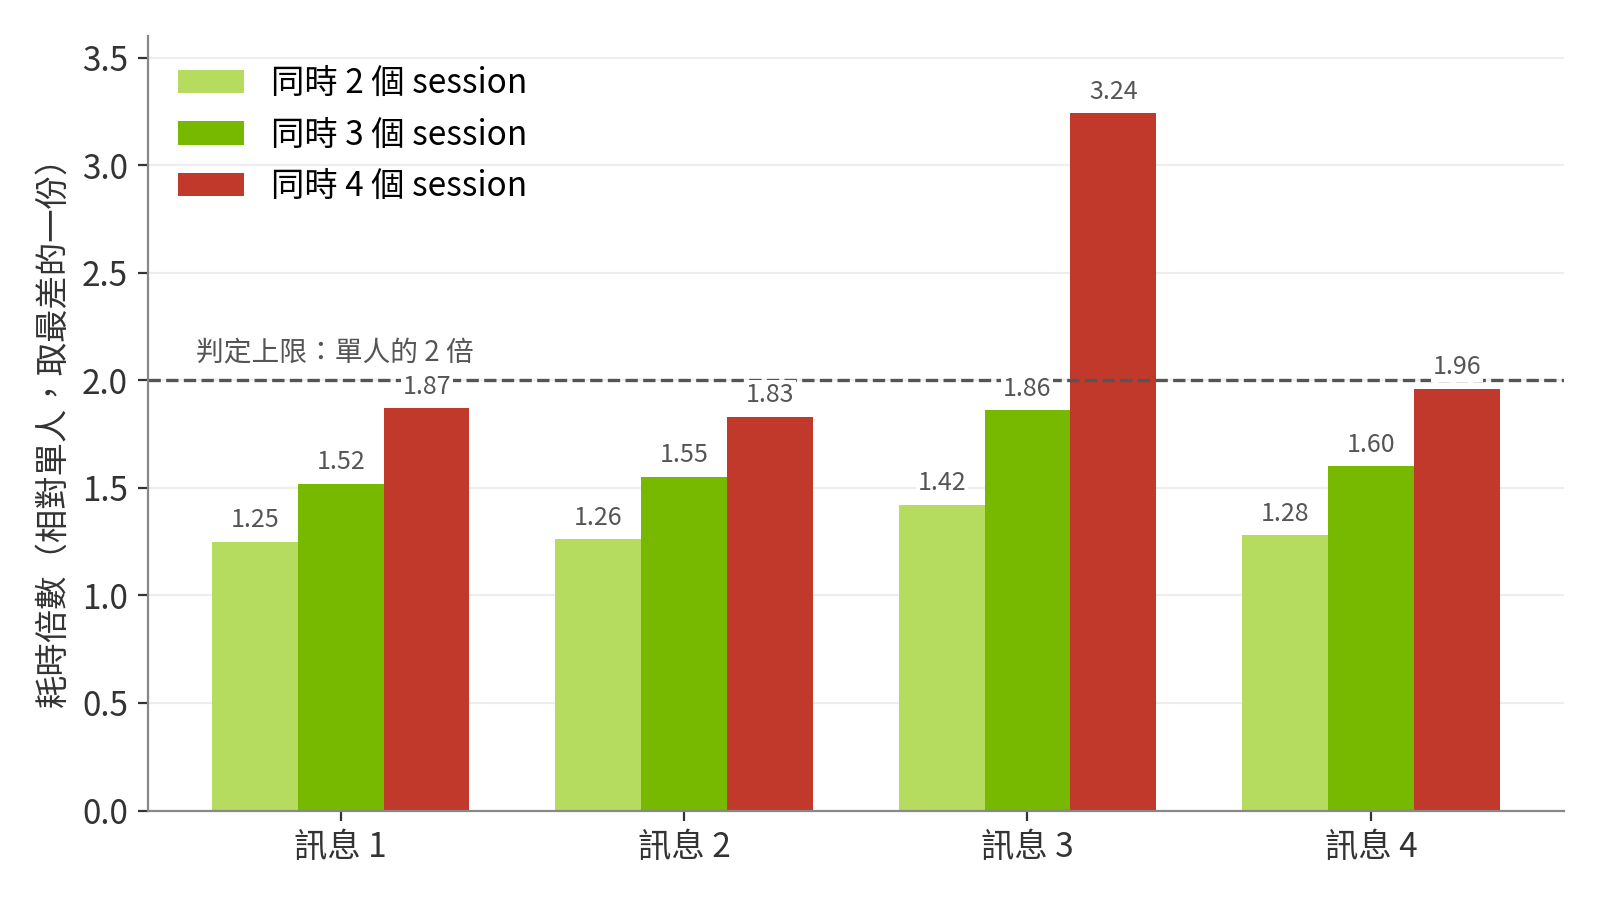
各則訊息在並發下的最差耗時倍數(虛線為判定上限)
同時 3 個任務時,最差的一則訊息已經到 1.86 倍,接近上限;到 4 個任務時,4 份的訊息 3 全部落在 3.02~3.24 倍。訊息 3 正好是每一份的背景檢討與主任務重疊的時段,最多 8 個請求同時執行,KV 快取被用滿,請求開始排隊。
變慢的原因:大家一起分頻寬
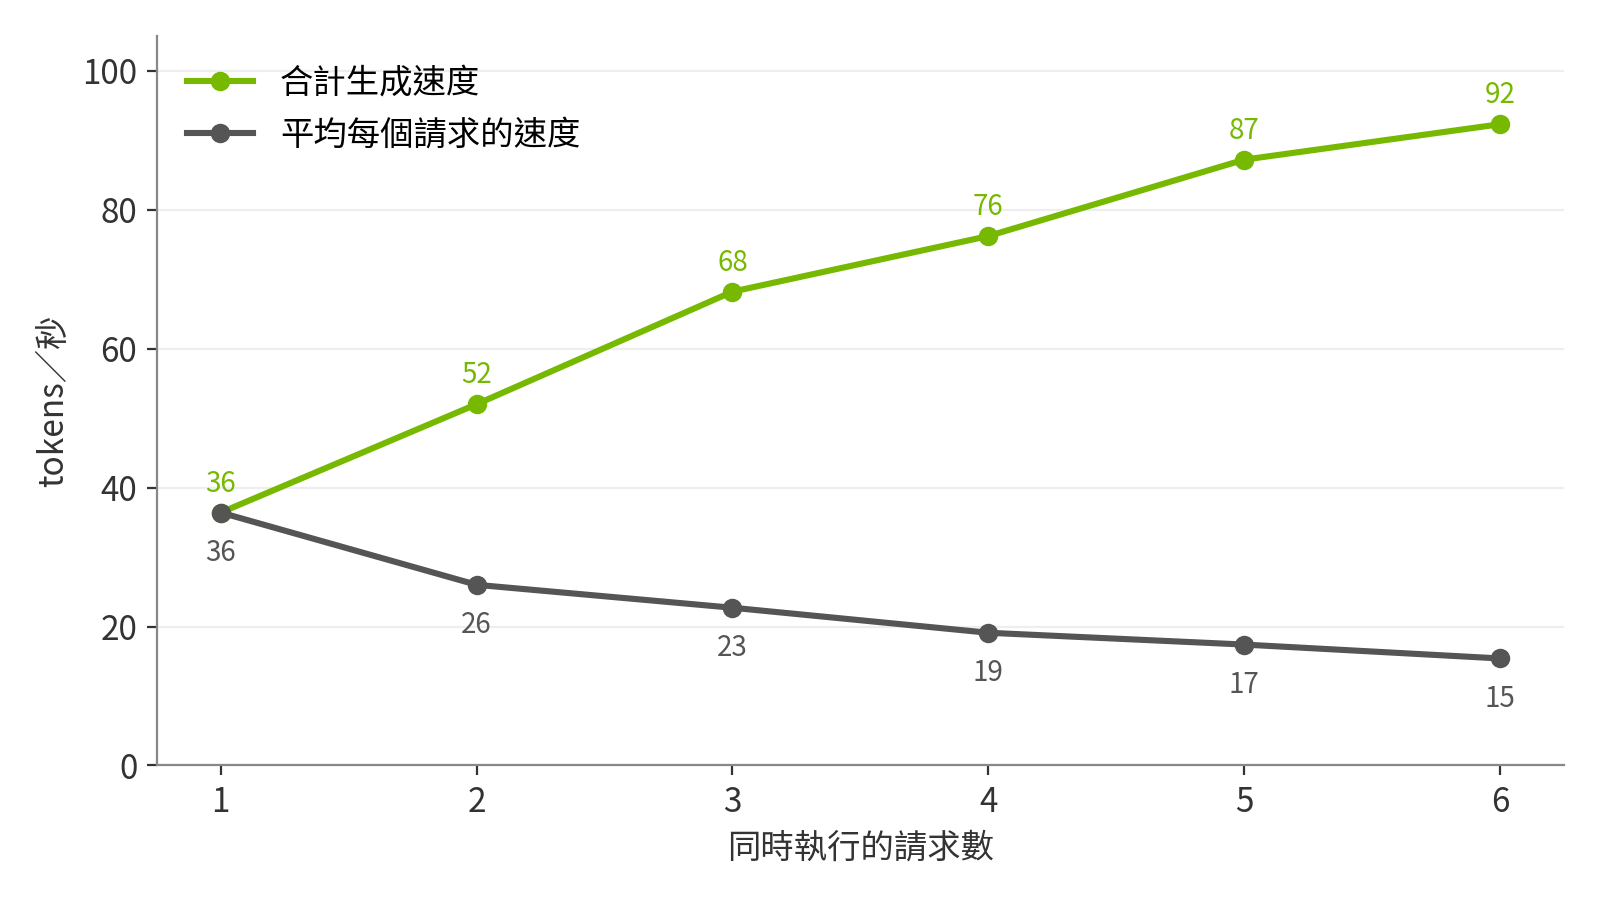
並發時的生成速度:合計速度上升,但每個請求變慢(同時 3 個任務時的推論引擎紀錄)
在 3 個任務以內,全程沒有任何請求排隊,首字延遲的中位數也幾乎不變。變慢的主因是所有請求共用 Spark 有限的頻寬:同時 6 個請求時,合計生成速度約為單一請求的 2.5 倍,但平均到每個請求,只剩約 4 成的速度。
最重要的一課:負載不是線性上升
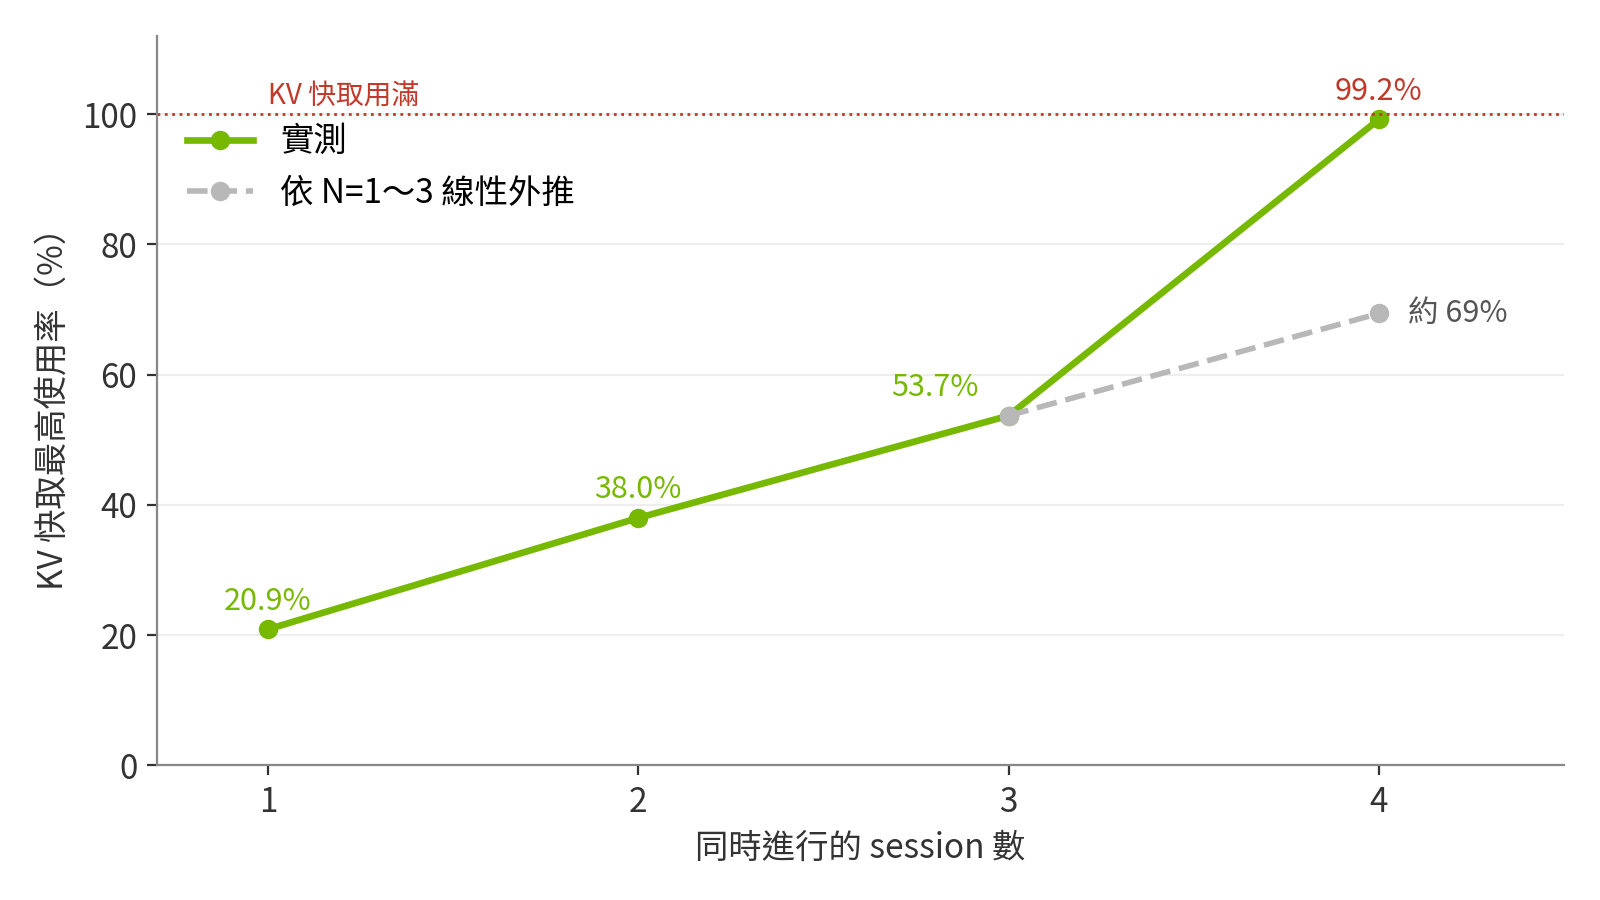
KV 快取最高使用率:實測值與線性外推的落差
跑完 3 個任務時,我們曾依前三個數據點線性推估:第 4 個任務時 KV 快取約用到 69%,最差倍數約 2.3 倍。實測卻是 99.2% 與 3.24 倍。原因是系統一變慢,背景檢討就拖得更久,與其他使用者的請求重疊得更多,負載是加速上升的。
並發承載量不能從低負載的數據外推,必須實測。以本次任務計,一台 DGX Spark 在「每則等待不超過單人 2 倍」的條件下,最多同時承載 3 個 agent 任務。
結論與建議
小資源適合做什麼
DGX Spark 與消費級顯示卡,很適合用來驗證工作流程:確認 agent 的 skill 寫得對不對、任務拆解是否合理、哪些地方需要人工把關。本次發現並修正的 skill 問題,就是在這樣的環境中驗證出來的。但要讓一個部門每天使用,需要的條件完全不同。
正式環境需要的四個條件
- 頻寬:決定每個人等多久。Spark 的生成速度已經貼近頻寬上限,調參數幾乎沒有空間
- KV 快取容量:決定能同時服務幾個人。Spark 在第 4 個任務時就用滿了
- 並發能力:agent 的負載會因背景作業而加速上升,容量必須留有餘裕
- 治理:測試中我們觀察到,agent 會嘗試自行安裝套件,背景檢討也會自行修改 skill,多人共用時會影響到其他人。正式環境需要存取控制、權限管理與稽核機制,GPU 資源的分配與治理可參考我們的 Run:ai 實測
各平台的承載推估
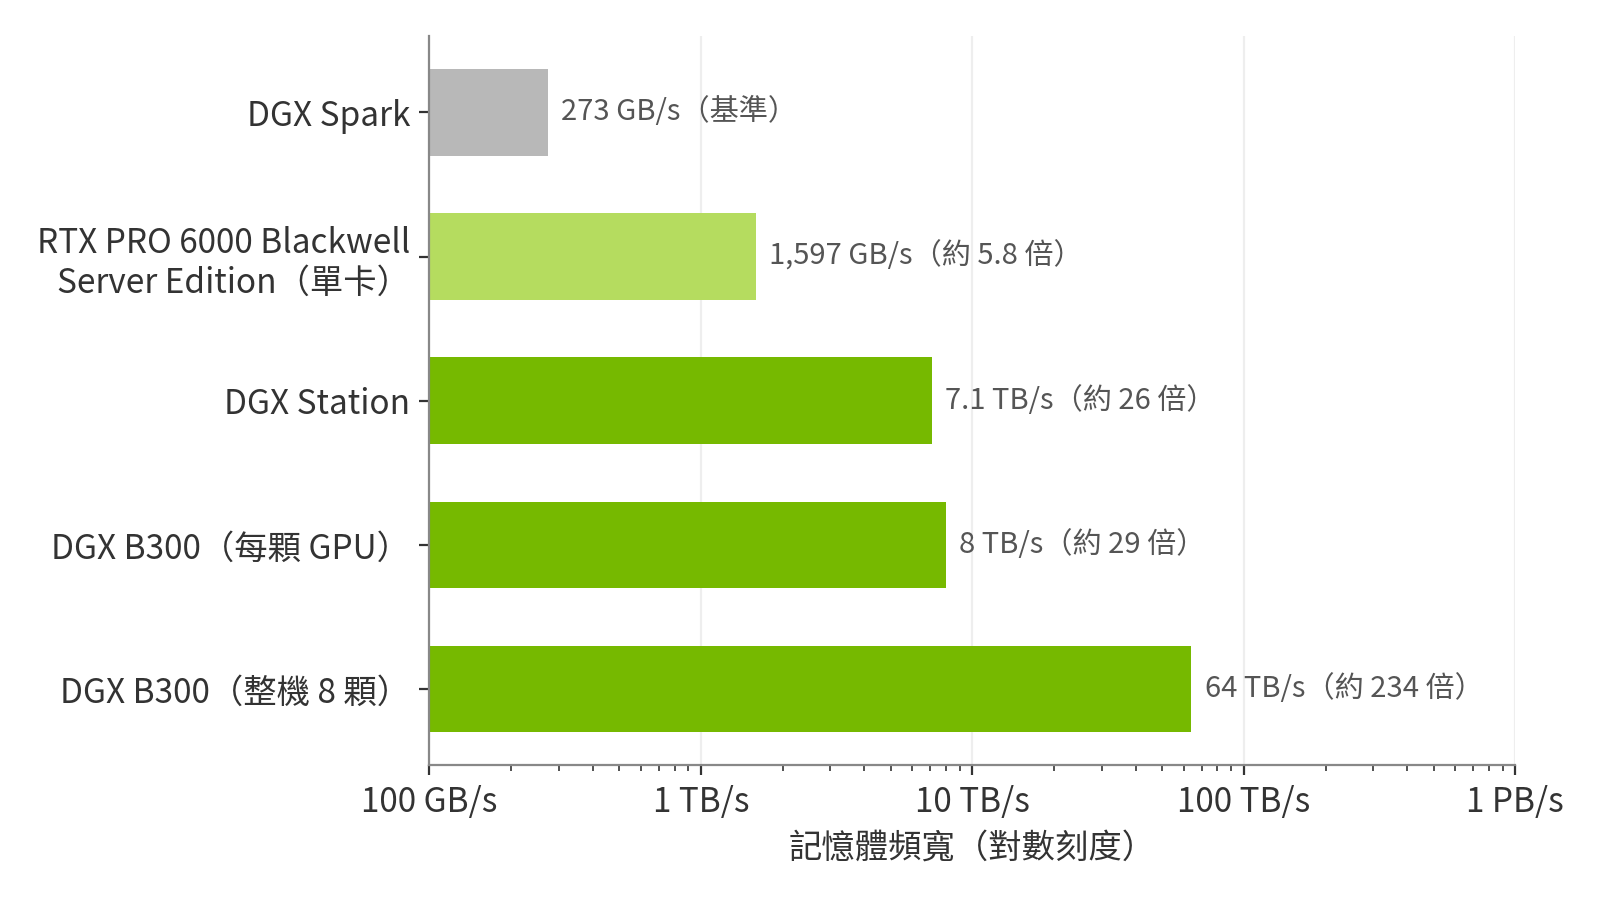
各平台記憶體頻寬比較(依 NVIDIA 官方規格)
| 平台 | GPU 記憶體 | 記憶體頻寬 | 推估同時任務數 | 主要限制 |
|---|---|---|---|---|
| DGX Spark | 128 GB(統一記憶體) | 273 GB/s | 3(實測) | 頻寬與 KV 快取 |
| RTX PRO 6000 Blackwell Server Edition(單卡) | 96 GB GDDR7 | 1,597 GB/s | 約 1 | 放入模型後,KV 快取只剩約 6 GiB |
| DGX Station | 252 GB HBM3e | 7.1 TB/s | 約 12~24 | KV 快取 |
| DGX B300 | 2.1 TB HBM3e(8 顆 GPU) | 64 TB/s(8 顆合計) | 每顆 GPU 約 13~26,整機約 100~200 | KV 快取 |
推估方法(依本次實驗數據推測,未實測)
一、每個任務的需求:S4 整輪約 39 分鐘,共產生約 6.8 萬個輸出 token,平均每秒約 29 個;最忙的時候約需要 13.5 萬 tokens 的 KV 快取(由 4 個任務用滿 Spark 的 KV 快取推算)。
二、平台的供給:生成能力以 Spark 多請求時的合計速度(每秒約 92 個 token)為基準,依記憶體頻寬等比例換算;KV 快取容量以 GPU 記憶體的 90% 扣除模型權重(約 75 GiB),再依 Spark 實測的換算比例(每 GiB 約 2.4 萬 tokens)計算。
三、兩者取小者為推估上限。這個方法套回 Spark,得到生成能力約 3.2、KV 快取約 4.0,取小者約 3,與實測一致。
四、由於只用一個實測點校準,且實驗顯示負載是非線性上升,建議值取推估上限的一半到上限。
五、以上皆以同一個模型(Qwen3.8-Flash-Next)與同一類任務計算;DGX B300 以 8 顆 GPU 各自執行一份模型估算;DGX Station 只計入 GPU 的 HBM3e,不含 CPU 端記憶體。「同時任務數」指同時在進行這類長文件任務的人數,不是帳號數。
六、本次任務不含上網查詢。實際工作若加上查詢,搜尋結果會讓對話變長、輸出變多,每個任務佔用的生成能力與 KV 快取都會增加,同時任務數應再往下修(推論)。
從推估可以看出幾件事(以下為我們的分析):
- DGX B300 是部門級、全公司級 agent 服務的選擇。即使只跑同一個中型模型,整機也能同時承載上百個長文件任務;它的記憶體也足以執行規模大得多的模型,為產出品質保留提升空間(模型規模能否改善本次觀察到的計算與推論錯誤,我們尚未在這個任務上驗證)
- DGX Station 適合小團隊共用或開發測試:依推估,一台放在辦公室的機器,就能讓十幾人同時進行這類任務
- RTX PRO 6000 適合入門的正式推論,但要注意模型大小:本次的模型放進單張 96 GB 的卡後所剩無幾,單一請求的 context 也必須降到約 15 萬 tokens 以下,又會回到 5070 Ti 上「背景作業撞牆」的風險。實務上應搭配較小的模型,或採用多卡配置
- DGX Spark 適合個人的驗證與 POC
同一台 DGX B300:有沒有 Run:ai,差距有多大
DGX B300 通常不會只用來跑推論,模型訓練與微調也會共用同一台機器。資源怎麼分配,會直接影響上班時段能服務多少人。以前面的推估(每顆 GPU 約 13~26 個同時任務)比較兩種做法(以下為推估):
| 配置方式 | 上班時段用於推論的 GPU | 推估同時任務數 | 下班後 |
|---|---|---|---|
| 固定切分:訓練、推論各一半 | 4 顆 | 約 52~104 | 推論的 4 顆大多閒置,訓練也無法使用 |
| Run:ai 動態調度:推論保證 90% | 約 7 顆(90% 為 7.2 顆,以整顆 GPU 部署一份模型計) | 約 91~182 | 推論需求下降後,訓練可借用閒置的 GPU |
同一台機器,上班時段可同時服務的任務數約多出 75%,而且下班後的算力也沒有浪費。做法是用 Run:ai 把推論的保證配額設為 90%,訓練只保證 10%,但允許訓練借用閒置資源(over-quota),推論服務則依同時請求數自動擴縮:下班後推論需求下降、副本縮減,訓練就能借用空出來的 GPU;上班後推論需求回升,排程器會把借出的資源收回給推論。
有兩點要注意。第一,Run:ai 的回收是需求驅動,不是依時段切換:只有在推論拿不到保證配額時才會收回。第二,推論服務擴充副本需要時間,模型越大越久(本次的 Flash-Next 在 Spark 上啟動約需 3 分鐘),正式服務應保留足夠的最少副本數,不能完全依賴臨時擴充。這些機制的觸發條件與邊界,可參考我們的 Run:ai 實測。
規劃 AI agent 平台時,建議先在小資源上把工作流程驗證清楚,再依「同時使用人數 × 每個任務的 context 長度」估算正式環境的 KV 快取需求,並保留足夠的餘裕。投資規模與 TCO 的評估方式,可參考〈K3 出現了,要自建嗎?我們先來算帳!〉。
附錄:測試細節
hermes 的壓縮門檻
| 模型的 context | 壓縮門檻 | 依據 |
|---|---|---|
| 64K(65,536) | 64,000 | 原始碼計算,並由實際紀錄確認 |
| 262K(262,144) | 196,608 | 原始碼計算(測試中未觸發壓縮) |
未設定輸出上限時,門檻為「context × 0.75」與最低值 64,000 取較大者。在 64K 的模型上,門檻幾乎等於上限,只剩約 1,500 tokens 給輸出,這也是背景作業容易撞牆的原因之一。
推論方案
| 輪次 | 引擎 | 模型與精度 | 加速方式 |
|---|---|---|---|
| S1 | llama.cpp | Qwen3.8-27B,4-bit 量化(UD-IQ4_XS) | — |
| S2 | SGLang | Qwen3.8-27B,NVFP4 | 推測解碼(DFlash2) |
| S3、S4 | vLLM(社群修改版) | Qwen3.8-Flash-Next,NVFP4(MoE) | MTP(一次推測 2 個 token) |
並發測試的請求組成(每一份)
| 類型 | 次數 | 說明 |
|---|---|---|
| 主任務 | 45 | 回應使用者訊息的模型呼叫,含工具呼叫的往返 |
| 背景檢討 | 22 | 兩次檢討,分別在訊息 2、訊息 4 之後執行 |
| 指令核准判斷 | 7 | agent 執行系統指令前,由模型判斷是否安全 |
| 對話標題產生 | 1 | 第一則訊息之後 |
資料來源
- NVIDIA,DGX Spark Hardware Overview:https://docs.nvidia.com/dgx/dgx-spark/hardware.html
- NVIDIA,DGX B300 產品頁(GPU 總記憶體 2.1 TB):https://www.nvidia.com/en-us/data-center/dgx-b300/
- NVIDIA,DGX B300 Datasheet(2.1 TB、64 TB/s HBM3e):原廠頁面;本文數值依其公開轉載版本:DGX B300 Datasheet(PDF)。註:部分經銷商資料列為 62 TB/s,較早版本的 datasheet 列為 2.3 TB,本文以 NVIDIA 較新版本的 datasheet 為準
- NVIDIA,DGX Station Datasheet(252 GB HBM3e、7.1 TB/s):NVIDIA DGX Station Datasheet;NVIDIA,DGX Station Development Guide:https://docs.nvidia.com/dgx/dgx-station-development-guide/overview.html。註:2025 年發表時的規格為 288 GB、8 TB/s,本文採用現行出貨規格
- NVIDIA,RTX PRO 6000 Blackwell Server Edition Datasheet(96 GB GDDR7、1,597 GB/s):NVIDIA RTX PRO 6000 Blackwell Server Edition Datasheet
- NousResearch,hermes-agent(本次測試版本 commit aaf9688):GitHub
- blazux,qwen3.8-Flash-DGX(Flash-Next 在 DGX Spark 上的部署方案):https://github.com/blazux/qwen3.8-Flash-DGX
- SGLang Cookbook,Qwen3.8-27B:https://docs.sglang.io/cookbook/autoregressive/Qwen/Qwen3.8-27B
- 其餘數據皆來自本次測試的 hermes、LiteLLM、llama.cpp、SGLang 與 vLLM 紀錄