
三個 Agent 一個窗口:讓 AI 像部門一樣分工,行得通嗎?
多 agent 分工與 A2A 協定實測:交接要靠什麼、能傳什麼、代價是什麼
摘要
前三篇談的都是一個 agent 跑一個任務:本地模型能不能撐起工作流、小資源能同時服務幾個人、消費級顯示卡的極限在哪裡。但真正的部門不會只有一個 agent。不同的 agent 各有所長,使用者只想面對一個窗口,把事情交出去就好。這一次,我們用三個 hermes agent 搭出「一個前台、兩個專家」的架構,實測 agent 之間怎麼交接:先試 hermes 內建的 A2A(Agent-to-Agent)協定,再看它做不到的那一半要怎麼補。
| 面向 | 實測結果 |
|---|---|
| 交接機制 | A2A 在文字任務上穩定:跨主機連線、token 認證、任務往返都正常,單次協定往返 8~9 秒。但這個版本的 A2A 傳不了檔案,兩個方向都不行 |
| 路由與交付 | 前台分派給正確專家的比率,正式測試題全部通過;同一個 Jira 匯出任務重複 8 次(A2A 與 Discord 交接各 4 次),8 次都產出正確的 Excel |
| 耗時 | 專家處理一題約 20~55 秒;使用者看到的整體時間約 1~2 分鐘,多出來的時間花在前台自己的模型 |
| 品質 | 第一次正式測試就失敗:agent 的記憶指向一個不存在的檔案、skill 文件裡寫錯的查詢式、再加上一個多餘的工具,三件事串成一條錯誤的路。其他問題還有簡體字、附件交接時重複交付一次 |
| 最終架構 | 混合制:只需要文字回答的任務走 A2A、前台轉告;附件、產出檔案與長任務走聊天平台的提及交接、專家直接交付;A2A 逾時就自動改走交接 |
結論是:讓 agent 像部門一樣分工,技術上行得通,而且文字任務的交接已經很穩。但多 agent 會把模型呼叫放大,前台本身就是瓶頸;治理上要管的東西(記憶、skill、工具、信任名單)也比單一 agent 多得多。這些都指向同一件事:撐起一個部門的,是平台,不是某一台主機。
為什麼要讓 agent 分工
我們日常用的 agent 有三個,各自跑在不同的主機、接不同的模型、裝不同的 skill:一個專門處理 Jira 與 Confluence(專案 WBS 匯出、逾期任務、工時統計),一個處理技術問題與文件(TCO 試算、文件摘要與撰寫),一個原本是個人用的測試機。
問題在於使用者。要找 Jira 的事得去找 A,技術問題得去找 B,還要記得哪台裝了什麼。我們想要的是:不管問什麼,都問同一個窗口;窗口自己判斷該交給誰,專家做完把結果交回來;使用者不需要知道後面有幾個 agent。
這就是本次的架構:一個前台(hermes-bot)加兩個專家(kenny-bot、spark-bot)。前台不執行任何任務,只負責理解需求、交辦、把結果交到使用者手上。
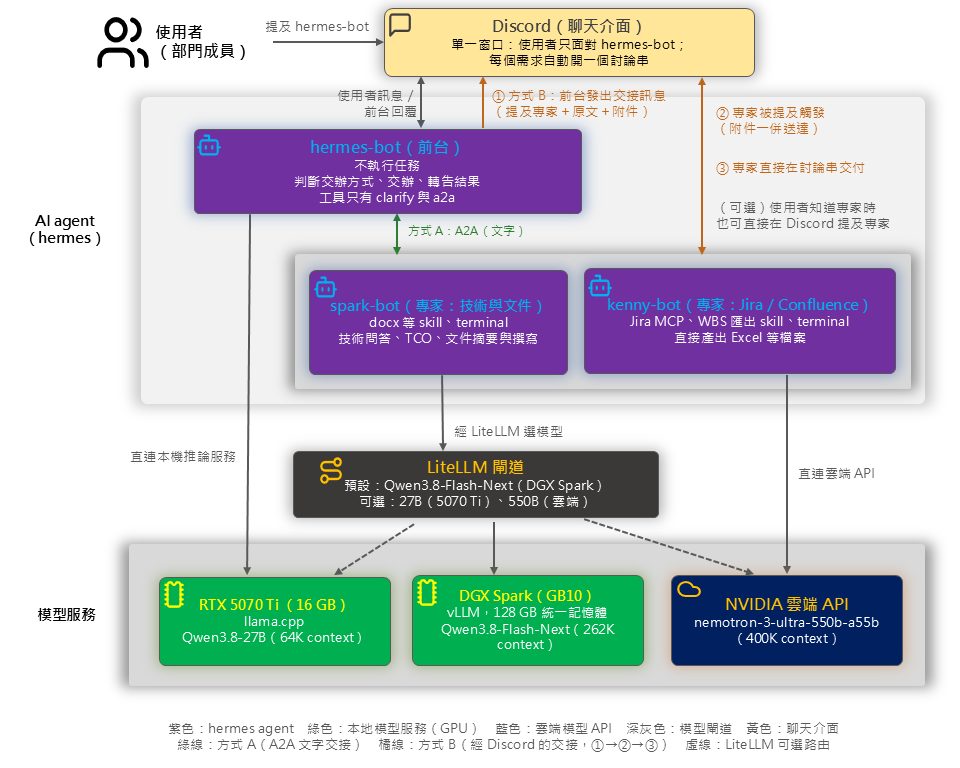 三個 agent 的角色、兩種交接方式與各自背後的模型
看圖的方式,由上往下:
- Discord 是唯一窗口。使用者只對 hermes-bot 說話:提及它、附上檔案,每個需求自動開一個討論串;使用者不需要知道後面有哪些專家。知道具體專家時也可以直接對專家提問,但那不是必要的流程。
- 三個 hermes agent 各司其職。hermes-bot 是前台,不執行任務,只判斷該走哪一種方式、交辦、轉告;kenny-bot 負責 Jira 與 Confluence;spark-bot 負責技術問答與文件。
- 方式 A(綠線):hermes-bot 用
a2a_call把文字任務直接交給專家,專家回文字,hermes-bot 轉告使用者。這是 agent 之間唯一不經過 Discord 的連線。 - 方式 B(橘線,①→②→③):hermes-bot 把交接訊息發到討論串(①:提及專家、照抄需求、附上檔案),專家被提及觸發、附件一併送達(②),再直接在討論串處理並交付檔案(③)。提及專家和轉送檔案都是 hermes-bot 做的,不是使用者;A2A 逾時或錯誤時也改走這條路。
- 模型層各走各的。kenny-bot 直連 NVIDIA 雲端 API(Nemotron 3 Ultra 550B);hermes-bot 直連工作站上的 llama.cpp(Qwen3.8-27B);spark-bot 經 LiteLLM 閘道,預設用 DGX Spark 上的 vLLM(Qwen3.8-Flash-Next),也可切到另外兩個模型(虛線為可選路由)。
| 角色 | agent | 模型 | 特點 |
|---|---|---|---|
| 前台 | hermes-bot | Qwen3.8-27B(llama.cpp,RTX 5070 Ti 工作站,16 GB) | 不執行任務;工具只剩「向使用者提問」與 A2A 呼叫 |
| 專家:Jira/Confluence | kenny-bot | Nemotron 3 Ultra 550B(NVIDIA 雲端 API) | Jira MCP、WBS 匯出 skill,直接產出 Excel |
| 專家:技術與文件 | spark-bot | Qwen3.8-Flash-Next(vLLM,DGX Spark;經 LiteLLM 閘道可切換其他模型) | docx 等文件 skill,技術問答、TCO、文件摘要 |
三個 agent 都是 hermes v0.22.5 系列,聊天介面是 Discord。
兩種交接方式
A2A:agent 之間直接對話的協定
A2A(Agent-to-Agent)是 Google 提出、現由 Linux Foundation 維護的開放協定,規格版本 v1.0。hermes 從 v0.20.0(2026 年 8 月)起內建了 A2A 外掛:每個 agent 可以對外公開一張「Agent Card」說明自己會什麼,其他 agent 用 JSON-RPC 送任務過來,回覆以任務結果傳回。
在 hermes 裡,被呼叫的那一端會把任務注入自己正在運作的工作階段,用的是同一套記憶、skill 與工具;呼叫端則是一個叫 a2a_call 的工具,由模型自己決定要不要用、交給誰。安全方面,沒設 token 時只綁本機;對外開放要同時設 token、綁定位址和信任名單;每則送進來的任務都會加上「來自其他 agent、視為不受信任的輸入」的前綴,回傳的文字會遮蔽金鑰,連 email 都會換成佔位字串。
它傳不了檔案,兩個方向都不行
我們一開始就希望附件能跟著交辦過去,專家做出來的 Excel 也能回來。查了三個 agent 所用版本的原始碼,答案是不行:
- 送出端:
a2a_call只有 agent、message(文字)、context_id 三個參數,沒有任何檔案參數 - 接收端:就算別的 A2A 客戶端送來檔案部件,hermes 只會把它轉成一行「[file: 檔名] 網址」的文字,直接夾帶的內容不會解碼存檔
- 回傳:任務結果只有文字部件
A2A 的規格本身支援檔案部件;hermes 這個版本的實作沒有做。這是評估任何 agent 框架時要記得的一課:協定支援不等於實作支援,要看你手上那個版本的程式碼。
Discord 提及交接:專家直接交付
另一條路是我們在前一輪就驗證過的做法:前台在討論串裡提及專家,把需求照抄一遍,附件一併轉送;專家被提及後,直接在同一個討論串處理並交付檔案。沒有協定,靠的是聊天平台本身。前台設定成不接收任何 bot 的訊息,所以兩個 bot 互相呼叫的迴圈在結構上不可能發生。
最後是混合制
| 情況 | 方式 | 誰交付 |
|---|---|---|
| 只需要文字回答,沒有附件,或附件內容已嵌在訊息裡(技術說明、查狀態、短摘要) | A2A,前台轉告 | 前台 |
| 附件內容沒有嵌進訊息(docx、xlsx、PDF、圖片) | Discord 提及交接,附件一併轉送 | 專家,直接在討論串 |
| 會產出檔案,或撰寫文件、產生報告這類很久的工作 | Discord 提及交接 | 專家,直接在討論串 |
| A2A 逾時或錯誤 | 改走 Discord 提及交接 | 專家,直接在討論串 |
這一整套規則全部寫在前台的人設檔(SOUL.md)裡,模型自己判斷該走哪一條。專家這邊也加了一段:收到其他 bot 交接的任務時,當成正式需求處理、在同一討論串交付、不要提及任何 bot。
實測一:文字任務走 A2A,穩
先做協定層:只開一個專家的接收端,從前台那台主機用 curl 讀 Agent Card、用錯誤的 token 送任務(應被拒絕)、再用正確的 token 送一句「請只回覆 OK」。三項都通過,往返 9 秒;另一個專家也是 8 秒。
接著讓前台以 agent 的身分真正交辦。正式測試題與結果:
| 題目 | 前台的判斷 | 專家處理 | 整體(使用者看到的) |
|---|---|---|---|
| 你好,你能幫我做什麼? | 自己回答(說明專家名單) | — | 即時 |
| 說明 Kubernetes 的 taint 和 toleration | 交給 spark-bot | 29 秒 | 約 2 分鐘 |
| 用 200 字說明 DGX Spark 的 TCO 考量 | 交給 spark-bot | 約 25 秒 | 約 1 分鐘 |
| 整理某專案的 WBS | 交給 kenny-bot | 約 50 秒 | 約 1 分鐘 |
| 附上一份 issue 清單(純文字檔),查狀態與負責人 | 交給 kenny-bot,清單內容以文字帶過去 | 約 20 秒 | 約 1 分鐘 |
前台送出的交辦內容,我們逐一核對稽核紀錄:除了附件那一題多了一句「以下是使用者提供的 issue 清單」,其餘都是使用者的原文,一字未改。轉告也完整。最值得一提的是最後一題:純文字附件的內容會被 hermes 直接嵌進訊息,前台把它原樣放進交辦,專家用 Jira MCP 逐一查詢後回覆。檔案本身沒有傳過去,但內容過去了,對這類需求,結果和傳檔案一樣。
同一個任務重複 8 次
為了確認穩定性,我們把 Jira WBS 匯出這一題分別用 A2A 直送 4 次、在 Discord 直接問專家 4 次,每次都用工作階段紀錄逐行判讀,看專家走的路徑。
- 8 次全部產出正確的 Excel
- 7 次都是「讀 skill → 直接用專案代碼執行匯出腳本 → 產出」三步;1 次(A2A)多花兩步先找一個對照檔,再照常執行
- A2A 每次 30~55 秒;兩種措辭(原文、前台改寫版)看不出差異
實測二:那一次失敗,教了我們三件事
穩定的結果是修正之後的。第一次正式讓前台交辦 WBS 匯出時,專家沒有產出 Excel,而是回了一個外部連接器的授權連結,要求使用者去瀏覽器點一下。我們沒有點,而是把工作階段紀錄一步一步攤開,找到了一條三段式的錯誤鏈:
| 段 | 發生的事 | 原因 |
|---|---|---|
| 1 | 專家先去讀一個不存在的對照檔 | 專家的長期記憶裡有一句「完整對照記錄在某 skill 的 references/… 檔案」。那個檔案早就不在了,skill 名稱也是舊的。記憶會過時,但模型照著做 |
| 2 | 找不到,改照 skill 文件查詢所有專案代碼,得到空值 | skill 文件裡的查詢式寫錯:Jira 這個端點回傳的是陣列,查詢式卻去取一個不存在的欄位。這一行寫了很久,之前從來沒人踩到,因為之前的專案代碼都在記憶裡,不用查 |
| 3 | 查不到,轉向「連接器」工具,對外部服務發起 Jira 授權 | 工具組裡多留了一個通用的連接器工具。前兩段失敗後,模型找到了這條退路 |
三段各有對應的修正:在 skill 裡建立真正的對照檔(直接從 Jira 產生,37 個專案),並更新記憶裡的指引;修正查詢式(Jira MCP 的 jq 參數其實是 JMESPath 語法,從套件原始碼確認);把連接器工具從專家的工具組永久移除。修正後重跑,專家讀 skill、讀對照檔、直接執行,一次完成。
這三件事和 A2A 本身沒有關係,換成單一 agent 也會發生,只是多 agent 把它放大了:前台交辦時不會替專家檢查記憶和 skill,專家出錯時前台也只能照實轉告。
agent 的治理,管的是三樣東西:記憶會過時、skill 文件會被逐字執行、每多一個工具就多一條不該走的路。第三點尤其要注意:那個授權連結指向一個託管服務,點下去就是把公司 Jira 的存取權交出去。我們的建議是,正式環境的 agent 只保留任務需要的工具,其餘一律拿掉;把 Agent Card 公開宣告的工具清單也縮到最小。
實測三:附件與檔案
純文字附件可以用內容傳遞,前面已經看到。那 docx 呢?hermes 對二進位附件(docx、PDF、圖片)的處理方式是只給路徑,並要 agent「自己用 terminal 之類的工具抽文字」。前台沒有這類工具,所以第一次測試時它誠實地告訴使用者讀不到、無法轉交,請使用者貼文字。這是正確的行為,但不是我們要的結果。
改成混合制之後,再上傳同一份 docx:前台在討論串提及 spark-bot、照抄需求、把檔案一併轉送;spark-bot 自己讀出文字,約 90 秒後交出三個重點,內容和原文相符。
但它交付了兩次。追查原因:hermes 送出交接時,文字和附件是兩則訊息(先文字、後附件);附件訊息對專家來說是另一個回合,模型把它當成新任務又做了一次。這是框架的固定行為,不是設定能改的;用人設檔規則去擋,這個模型(Flash-Next)不一定遵守。我們把它列為已知限制:多花 40 秒和一則重複的訊息,結果本身是正確的。
另外,A2A 逾時的退路也驗證過:把前台對 spark-bot 的逾時暫時改成 5 秒,送一題文字問題,前台在逾時後照規則改走 Discord 交接,並附註原因。
耗時:前台才是瓶頸
看「說明 taint 和 toleration」那一題:spark-bot 從收到到回覆只花 29 秒,使用者卻等了約 2 分鐘。多出來的時間,是前台自己的模型(RTX 5070 Ti 上的 27B)在交辦前讀工具說明、交辦後整理轉告。每一次交辦,前台至少要跑兩輪模型;專家那邊除了主任務,背景還有自己的作業。
也就是說,使用者的一個需求,在多 agent 架構下會變成兩到三次模型呼叫,而且分布在不同的機器上。前一篇算過小資源平台能同時服務幾個人;套上多 agent 架構時,這個數字要再除以每個需求觸發的呼叫次數,而且前台的模型要夠快,否則專家再快也沒有用。
還有兩個品質問題值得記下:spark-bot 的回覆偶爾混入簡體字,走 A2A 時前台轉告會順手轉成繁體,走 Discord 交接時使用者會直接看到;前台一度在交接時「加料」,把「整理 WBS」展開成使用者沒說的步驟和格式,改成「照抄原文」的規則後才消失。這兩件都是模型的行為,不是協定的問題。
對企業的意義
行得通的部分
一個前台加多個專家、使用者只面對一個窗口,用現成的開源框架就做得到。文字任務走 A2A 很穩,交辦內容忠實、轉告完整,而且每一次交接都有稽核紀錄(誰送了什麼、誰回了什麼)。
要先想清楚的部分
- 交接協定能傳什麼,決定了架構。先用實際任務(含附件、含產出檔案)測一遍,再決定哪些工作走協定、哪些走別的路。本次的答案是混合制
- 多 agent 的並發是乘法,不是加法。一個需求觸發多次模型呼叫,前台和每個專家都要有足夠的推論資源;前台的模型尤其要快。規劃平台時,先算「同時使用的人數 × 每個需求的呼叫次數」,再看單一主機撐不撐得住。前一篇的人數推估是起點,不是答案
- 治理的面積變大了。記憶、skill、工具、信任名單、token,每個 agent 各一份。這些東西在實驗環境靠人盯,在正式環境需要集中的身份管理、稽核與資源調度。GPU 資源的分配與治理,可以參考我們的 Run:ai 實測
我們的建議和前幾篇一致:先在小資源上把分工、交接規則和 skill 驗證清楚,再依人數與呼叫次數規劃正式平台。本次三個 agent 分散在三台機器、三種模型上,已經能跑;但要讓一個部門的人同時用、穩定用、可管理,需要的是能同時承載多個模型、集中調度的平台,而不是再多買幾台工作站。
測試條件說明
一、三個 agent 都是 hermes v0.22.5 系列;A2A 的行為描述取自各 agent 所用版本的原始碼,換用其他框架或版本,結果可能不同。
二、正式測試題多數只跑一次;重複測試的 8 次中,「先去找對照檔」的偏離在 A2A 出現 2 次(含第一次失敗)、Discord 0 次,Fisher 精確檢定 p 約 0.44,這個樣本數分不出平台差異。
三、耗時是從聊天訊息時間戳記與稽核紀錄推得的概數,受前台模型的負載影響;專家的處理時間取自 A2A 稽核紀錄的收訊與回覆時間差。
四、TCO 這類超過 30 分鐘的長任務本次沒有重測,依混合制規則走 Discord 交接,與前一輪驗證過的路徑相同。
五、專案名稱、Jira 內容與所有金鑰、位址一律不揭露。
資料來源
- Nous Research,Hermes Agent 使用者手冊:A2A (Agent-to-Agent):https://hermes-agent.nousresearch.com/docs/user-guide/messaging/a2a
- Nous Research,Hermes Agent v0.20.0 發行說明(2026-08-03,內建 A2A 外掛):https://github.com/nousresearch/hermes-agent/releases/tag/v2026.8.3
- Linux Foundation,A2A Protocol 規格(v1.0):https://a2a-protocol.org/
- Hermes Agent 原始碼,A2A 外掛(本文引用的行為:呼叫端工具參數 tools.py、接收端訊息與結果處理 protocol.py、安全與遮蔽 security.py、Agent Card 宣告 adapter.py):https://github.com/NousResearch/hermes-agent/tree/cb757fac59c/plugins/platforms/a2a
- Hermes Agent 原始碼,Discord 外掛與 gateway(文字與附件分兩則送出、附件訊息另起回合):plugins/platforms/discord/adapter.py、gateway/platforms/base.py
- aashari,mcp-server-atlassian-jira 3.3.0(jq 參數以 JMESPath 實作):https://www.npmjs.com/package/@aashari/mcp-server-atlassian-jira
- JMESPath 規格:https://jmespath.org/
- 其餘數據皆來自本次測試的 hermes 工作階段紀錄、A2A 稽核紀錄與 LiteLLM 紀錄